Kubernetes untuk GPU Server: Kapan Dibutuhkan?
September 23, 2026
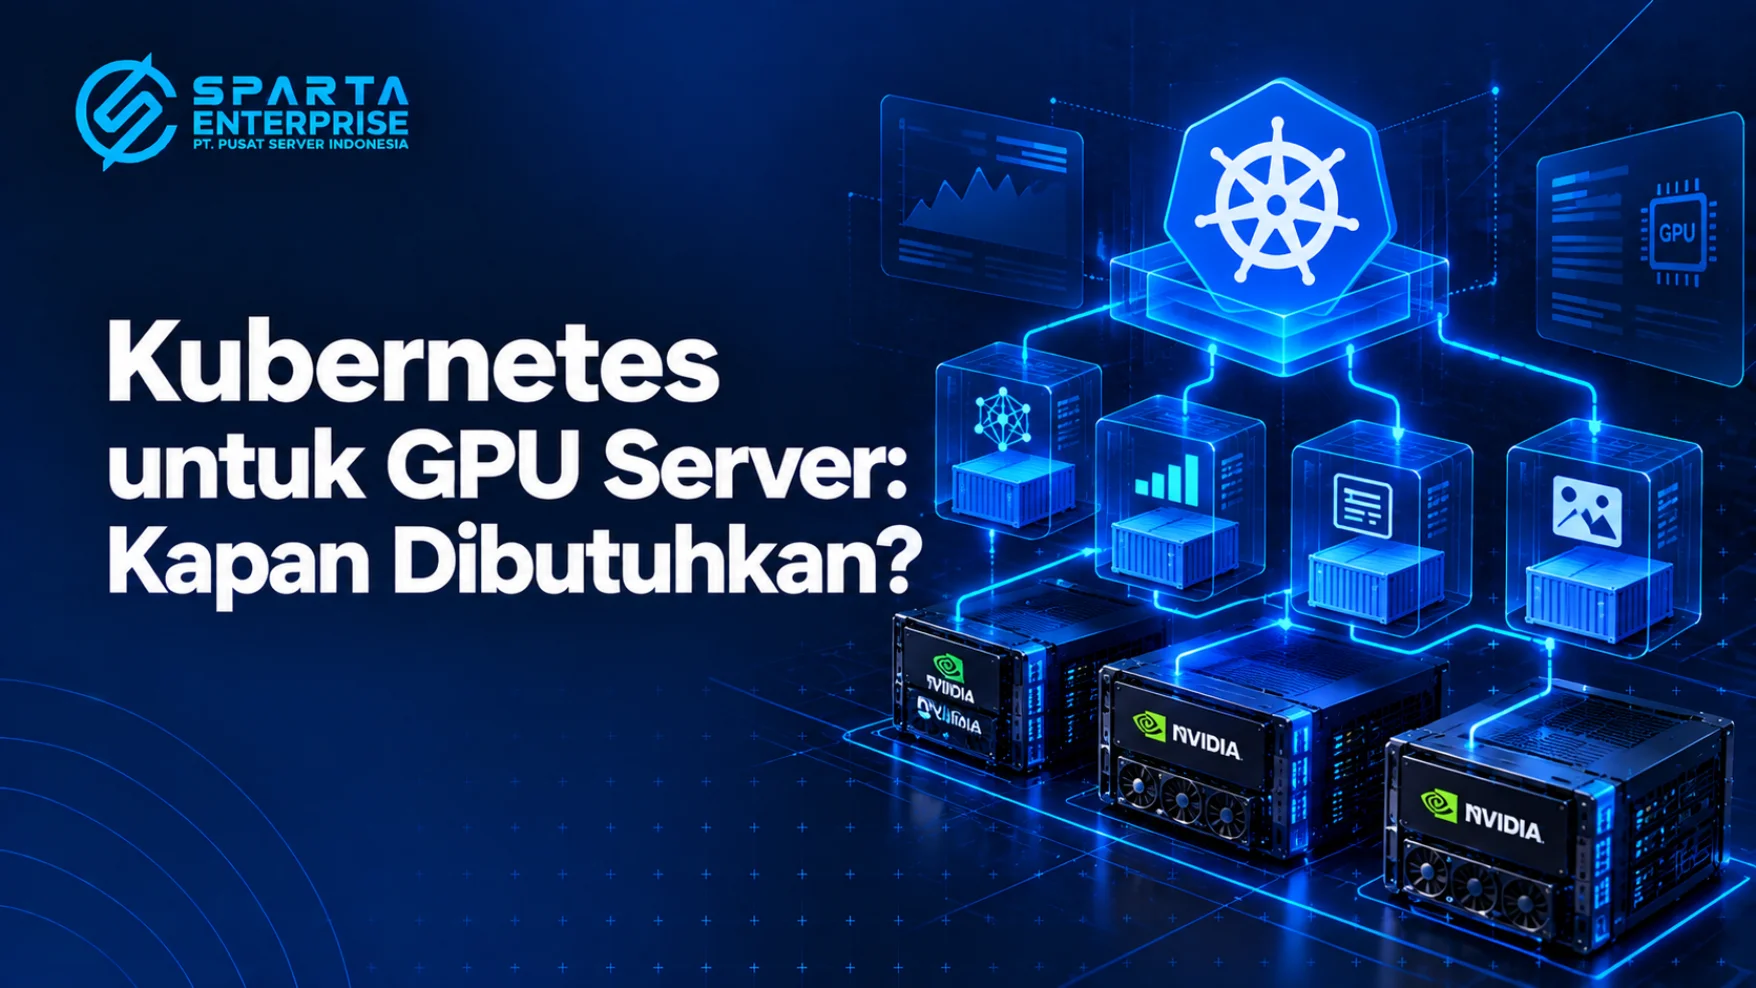
Kubernetes GPU mulai menarik perhatian ketika perusahaan tidak lagi hanya menjalankan satu aplikasi AI pada satu GPU Server. Saat jumlah server, GPU, aplikasi, dan pengguna bertambah, tim IT membutuhkan cara yang lebih terstruktur untuk mengatur workload komputasi.
Bayangkan perusahaan menjalankan LLM, machine learning, deep learning, dan computer vision secara bersamaan. Setiap aplikasi membutuhkan resource GPU dengan karakter berbeda. Tanpa orkestrasi yang tepat, tim IT harus mengatur deployment, penggunaan GPU, scaling, dan monitoring secara manual. Kubernetes dapat membantu mengatasi kompleksitas tersebut.
Namun, perusahaan tidak selalu membutuhkan Kubernetes hanya karena memiliki GPU Server. Infrastruktur sederhana dengan satu server dan satu aplikasi mungkin masih cukup menggunakan deployment langsung. Artikel ini membahas cara kerja Kubernetes untuk GPU Server, manfaatnya, serta kondisi ketika perusahaan mulai membutuhkan GPU orchestration.
Sebelum menerapkan Kubernetes GPU, perusahaan perlu memahami hubungan antara Kubernetes, container, dan GPU. Kubernetes berfungsi sebagai platform orkestrasi yang mengatur aplikasi dalam container pada satu atau beberapa server. Kubernetes mengenali GPU sebagai resource melalui mekanisme device plugin. Setelah administrator memasang komponen yang sesuai, Kubernetes dapat mengetahui GPU yang tersedia pada setiap node. Aplikasi kemudian dapat meminta GPU sebagai resource ketika menjalankan Pod.
Sebagai contoh, sebuah layanan LLM membutuhkan satu GPU untuk menjalankan inference. Kubernetes dapat mencari node yang mempunyai GPU sesuai kebutuhan dan menempatkan Pod pada node tersebut. Dengan pendekatan ini, Kubernetes GPU Server tidak menggantikan GPU Server. Kubernetes justru menambahkan lapisan orkestrasi agar perusahaan dapat mengelola aplikasi yang menggunakan GPU secara lebih terstruktur.
Kubernetes GPU mulai memberikan manfaat ketika perusahaan menghadapi lingkungan komputasi yang lebih kompleks. Jumlah server, aplikasi, dan pengguna menjadi faktor yang lebih penting daripada sekadar jumlah GPU.
Satu GPU Server relatif mudah dikelola secara manual. Namun, pengelolaan menjadi lebih rumit ketika perusahaan memiliki beberapa node dengan GPU berbeda. Kubernetes dapat menggabungkan beberapa server tersebut ke dalam satu cluster. Administrator kemudian dapat menggunakan label dan selector untuk membedakan tipe GPU pada setiap node. Misalnya, perusahaan dapat memberikan label khusus untuk node yang menggunakan NVIDIA H100. Kubernetes kemudian dapat mengarahkan workload tertentu ke node tersebut berdasarkan kebutuhan aplikasi.
Kubernetes memungkinkan administrator mendefinisikan kebutuhan GPU pada workload. Aplikasi dapat meminta satu atau beberapa GPU sesuai kebutuhan. Pendekatan ini membantu tim IT mengurangi pengaturan manual. Administrator cukup menentukan kebutuhan resource dalam konfigurasi deployment, lalu Kubernetes menjalankan mekanisme scheduling sesuai resource yang tersedia.
Perusahaan dapat menjalankan berbagai jenis GPU workload, seperti LLM inference, deep learning, computer vision, dan machine learning training. Setiap aplikasi dapat menggunakan Pod dan konfigurasi masing-masing. Kubernetes kemudian membantu tim mengelola aplikasi tersebut dalam satu lingkungan yang terstruktur.
Tidak semua perusahaan perlu langsung menggunakan Kubernetes. Tim IT sebaiknya melihat kompleksitas lingkungan terlebih dahulu sebelum menambahkan platform orkestrasi.
| Kondisi Infrastruktur | Kebutuhan Kubernetes GPU |
|---|---|
| Satu GPU Server dan satu aplikasi | Belum tentu perlu |
| Satu server dengan beberapa aplikasi AI | Mulai layak dipertimbangkan |
| Beberapa GPU Server | Relevan |
| Banyak pengguna dan workload | Sangat membantu |
| Multi-GPU dan multi-node | Relevan |
| Distributed training | Dapat membantu |
| LLM inference berskala besar | Relevan sesuai arsitektur |
| Banyak aplikasi berbasis container | Relevan |
Jadi, perusahaan tidak perlu menggunakan Kubernetes hanya karena memiliki GPU Server. Kubernetes menjadi lebih relevan ketika tim membutuhkan scheduling, scaling, deployment otomatis, dan pengelolaan banyak workload.
Setelah memahami kebutuhan dasarnya, perusahaan perlu mengetahui komponen yang menghubungkan Kubernetes dengan GPU. Infrastruktur tersebut membutuhkan driver, container runtime, dan komponen integrasi GPU yang kompatibel.
NVIDIA device plugin memungkinkan Kubernetes mengenali GPU NVIDIA pada sebuah node. Setelah administrator memasang plugin, Kubernetes dapat menyediakan resource seperti nvidia.com/gpu kepada Pod. Aplikasi kemudian dapat meminta resource tersebut melalui konfigurasi container. Kubernetes menggunakan informasi tersebut ketika memilih node untuk menjalankan workload.
NVIDIA juga menyediakan NVIDIA GPU Operator untuk membantu administrator mengelola komponen GPU pada Kubernetes. Operator tersebut dapat membantu mengatur driver, container toolkit, device plugin, node labeling, serta komponen monitoring tertentu. Pendekatan ini dapat mengurangi pekerjaan konfigurasi manual, terutama ketika perusahaan mengelola banyak node GPU. Tim IT tetap perlu memeriksa kompatibilitas versi Kubernetes, driver, GPU, dan sistem operasi sebelum melakukan deployment.
Kebutuhan Kubernetes untuk AI semakin terlihat ketika perusahaan menjalankan beberapa aplikasi LLM atau Generative AI. Tim dapat menjalankan layanan inference, eksperimen model, fine-tuning, maupun aplikasi AI internal dalam lingkungan yang sama. Sebagai contoh, satu Pod dapat menjalankan layanan chatbot internal, sedangkan Pod lain menjalankan model untuk analisis dokumen. Kubernetes dapat membantu tim mengatur deployment kedua layanan tersebut berdasarkan resource yang tersedia.
Namun, Kubernetes tidak otomatis meningkatkan kecepatan LLM. Performa tetap bergantung pada GPU, VRAM, model, inference engine, batch size, storage, dan jaringan. Untuk kebutuhan tersebut, Sparta menyediakan Server AI untuk LLM & Generative AI yang dapat perusahaan sesuaikan dengan kebutuhan model dan komputasi.
Selain LLM, perusahaan juga dapat menggunakan Kubernetes machine learning untuk mengelola training dan inference. Kedua jenis workload tersebut mempunyai karakteristik berbeda. Training biasanya menggunakan GPU dengan beban komputasi tinggi selama periode tertentu. Sementara itu, inference dapat berjalan terus-menerus dan membutuhkan latency yang konsisten.
Kubernetes dapat membantu tim mengelola beberapa eksperimen dan layanan secara terstruktur. Untuk distributed training, tim juga perlu memperhatikan komunikasi antar-GPU, storage, dan jaringan. Sparta menyediakan Server Machine Learning & Deep Learning untuk kebutuhan training, inference, dan workload AI yang membutuhkan GPU.
Kemampuan Kubernetes dalam mengelola penggunaan GPU tidak berarti setiap GPU otomatis terbagi menjadi beberapa bagian. Metode pembagian GPU bergantung pada hardware dan teknologi yang perusahaan gunakan.
NVIDIA menyediakan beberapa pendekatan, termasuk time-slicing dan Multi-Instance GPU atau MIG pada GPU yang mendukung teknologi tersebut. Administrator dapat memilih pendekatan berdasarkan karakter aplikasi dan kebutuhan isolasi resource. Perusahaan perlu membedakan kebutuhan GPU penuh, GPU sharing, dan partisi GPU. Setiap metode memiliki karakteristik performa dan konfigurasi yang berbeda.
Kubernetes GPU membutuhkan beberapa komponen pendukung agar cluster dapat menjalankan aplikasi secara stabil. Perusahaan perlu merancang server, storage, networking, dan software sebagai satu kesatuan.
GPU Server menjadi fondasi komputasi untuk menjalankan AI. Sparta menyediakan GPU Server Indonesia dengan pilihan NVIDIA H100, H200, B200, L40S, dan RTX PRO. Tim dapat menyesuaikan konfigurasi berdasarkan kebutuhan VRAM, jumlah GPU, model AI, dan rencana pengembangan cluster.
CPU mendukung container runtime, preprocessing, aplikasi pendukung, dan komunikasi dengan GPU. RAM menjalankan sistem operasi, aplikasi, cache, serta proses pendukung lainnya. Tim IT perlu menghitung kebutuhan CPU dan RAM berdasarkan seluruh workload, bukan hanya jumlah GPU.
Storage menyimpan model, container image, dataset, checkpoint, log, dan data aplikasi. NVMe dapat membantu mempercepat proses read/write pada workload tertentu. Perusahaan juga dapat menambahkan storage terpisah ketika beberapa node membutuhkan akses ke dataset atau model yang sama.
Networking menjadi semakin penting ketika perusahaan menjalankan Kubernetes GPU dalam konfigurasi multi-node. Distributed training, storage terpusat, dan komunikasi antarlayanan dapat membutuhkan bandwidth tinggi serta latency rendah. Karena itu, tim perlu merancang Infrastruktur & Networking bersamaan dengan GPU Server agar seluruh komponen dapat berkomunikasi secara optimal.
Kubernetes bukan solusi wajib untuk setiap GPU Server. Platform ini menambahkan lapisan manajemen yang juga membutuhkan konfigurasi, monitoring, keamanan, dan maintenance. Jika perusahaan hanya menjalankan satu aplikasi AI pada satu server, deployment langsung mungkin sudah memenuhi kebutuhan. Tim juga belum tentu membutuhkan Kubernetes ketika jumlah pengguna masih sedikit dan aplikasi tidak membutuhkan scaling.
Perusahaan dapat mulai mempertimbangkan Kubernetes ketika jumlah aplikasi, container, GPU Server, dan pengguna meningkat. Kebutuhan multi-node juga dapat menjadi indikator bahwa perusahaan membutuhkan orkestrasi yang lebih terstruktur.
Ketika perusahaan sudah memiliki kebutuhan yang sesuai, Kubernetes GPU dapat membantu tim IT mengelola infrastruktur AI dengan lebih terorganisasi.
Beberapa manfaatnya meliputi:
Namun, Kubernetes tetap membutuhkan desain arsitektur yang tepat. Platform ini tidak menggantikan GPU Server, storage, networking, atau inference engine.
Sebelum membangun Kubernetes GPU Server, perusahaan sebaiknya melakukan assessment. Langkah ini membantu tim menentukan hardware dan software yang sesuai dengan workload.
Beberapa hal yang perlu diperiksa meliputi:
Sparta menyediakan layanan Core Server & Infrastruktur untuk membantu kebutuhan server, storage, konfigurasi, instalasi, testing, dan dukungan infrastruktur. Selain itu, layanan Managed IT & Support dapat membantu kebutuhan setup Proxmox, VMware, Mikrotik, dan Cisco, instalasi serta konfigurasi server dan jaringan, maintenance, troubleshooting, hingga IT support.
Kubernetes GPU akan bekerja lebih optimal ketika perusahaan merancang seluruh infrastrukturnya secara terpadu. Tim perlu mempertimbangkan compute, storage, networking, monitoring, keamanan, dan dukungan operasional sejak awal. Sparta menyediakan NVIDIA GPU Server Indonesia untuk kebutuhan AI, LLM, machine learning, deep learning, dan HPC. Perusahaan dapat memilih GPU seperti H100, H200, B200, L40S, atau RTX PRO sesuai kebutuhan workload.
Untuk kebutuhan jaringan, Sparta juga menyediakan Network & Routing, termasuk Network & Internet Services serta Mikrotik & Routing Solutions. Sementara itu, kebutuhan Data, Monitoring & Availability dapat mendukung monitoring & operations, data & analytics, serta high availability & recovery. Jika perusahaan membutuhkan dukungan berkelanjutan, layanan Rental, Maintenance & Lifecycle juga mencakup maintenance plan, rental perangkat IT, dan layanan IT lifecycle.
Kubernetes GPU paling relevan ketika perusahaan mulai mengelola banyak GPU Server, aplikasi AI, container, pengguna, atau workload yang membutuhkan pengaturan resource secara terstruktur.
Untuk satu GPU Server dengan satu aplikasi sederhana, perusahaan dapat mempertahankan arsitektur yang lebih sederhana. Namun, ketika kebutuhan berkembang menjadi multi-GPU, multi-node, LLM, machine learning, deep learning, atau distributed training, Kubernetes dapat membantu tim mengelola lingkungan tersebut.
Sparta Server Indonesia dapat membantu kebutuhan GPU Server Indonesia, Server AI, Machine Learning & Deep Learning, Core Server & Infrastruktur, Network & Routing, hingga Managed IT & Support. Dengan melakukan assessment sejak awal, perusahaan dapat menentukan kombinasi GPU, CPU, RAM, storage, networking, dan orkestrasi yang sesuai dengan kebutuhan sebenarnya.
Kubernetes GPU adalah penggunaan Kubernetes untuk mengelola workload yang membutuhkan GPU pada satu atau beberapa node.
Tidak. Kubernetes lebih cocok ketika perusahaan mempunyai banyak workload, GPU Server, pengguna, atau kebutuhan orkestrasi container.
Bisa. Kubernetes dapat menggunakan NVIDIA GPU melalui device plugin dan NVIDIA GPU Operator.
Bisa. Kubernetes cocok untuk lingkungan LLM yang membutuhkan pengelolaan beberapa layanan, container, atau scaling.
Bisa. Kubernetes dapat mengelola beberapa GPU sebagai resource, sedangkan konfigurasi multi-GPU tetap bergantung pada hardware dan software stack.