Speculative Decoding LLM: Cara Kerja dan Manfaatnya
September 23, 2026
Bayangkan sebuah LLM harus menghasilkan ratusan token satu per satu. Semakin besar model yang digunakan, semakin besar pula kebutuhan komputasi saat inference. Lalu, bagaimana jika proses tersebut bisa dipercepat tanpa harus mengganti model utama? Di sinilah speculative decoding LLM menjadi salah satu pendekatan optimasi yang menarik.
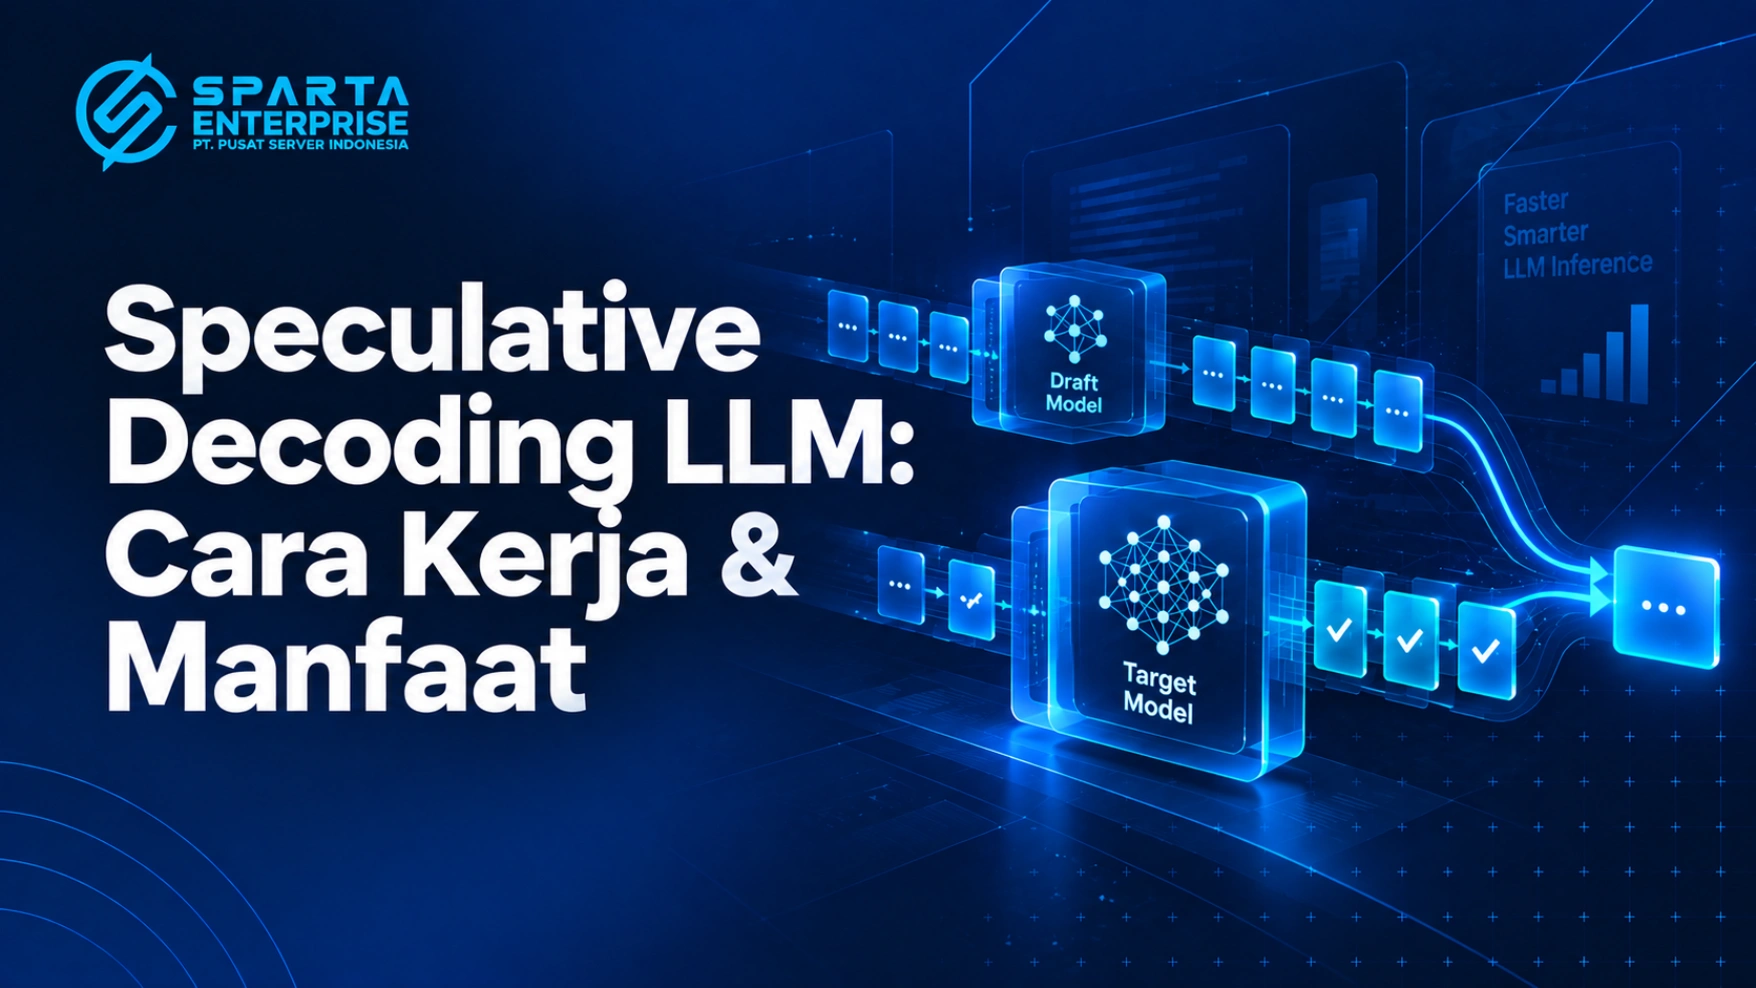
Speculative decoding LLM bekerja dengan memanfaatkan model atau komponen yang lebih ringan untuk menebak beberapa token berikutnya, kemudian model utama memeriksa tebakan tersebut. Jika tebakan sesuai, beberapa token dapat diterima dalam satu siklus forward pass. Pendekatan ini dirancang untuk mengurangi latency pada proses generasi teks, terutama pada skenario dengan batch size kecil.
Artikel ini membahas pengertian speculative decoding LLM, cara kerja, komponen yang dibutuhkan, manfaat, keterbatasan, hingga kebutuhan infrastruktur GPU server untuk menjalankannya.
Speculative decoding LLM adalah teknik optimasi inference yang memungkinkan LLM menghasilkan beberapa token dalam satu iterasi dengan bantuan prediksi awal dari komponen yang lebih cepat. Teknik ini juga dikenal sebagai speculative sampling dalam beberapa literatur.
Pada metode decoding biasa, target model menghasilkan token secara berurutan. Artinya, model perlu melakukan proses berulang untuk menghasilkan rangkaian teks. Pada speculative decoding, proses tersebut dibantu oleh draft model atau mekanisme prediksi lain yang lebih ringan.
Secara sederhana, terdapat dua komponen utama:
Jika banyak draft token diterima, jumlah iterasi yang diperlukan untuk menghasilkan teks dapat berkurang.
Memahami alurnya membantu menjelaskan mengapa teknik ini dapat meningkatkan efisiensi inference. Prosesnya tidak sekadar menjalankan dua model secara bersamaan, tetapi melibatkan tahap prediksi dan verifikasi.
Tahap pertama dimulai ketika draft model menghasilkan beberapa token yang diperkirakan menjadi kelanjutan dari teks. Karena ukurannya lebih kecil atau mekanismenya lebih ringan, proses prediksi ini dapat dilakukan dengan lebih cepat. Sebagai contoh, draft model dapat mengusulkan beberapa token sekaligus berdasarkan konteks yang sudah tersedia. Prediksi tersebut belum langsung diberikan kepada pengguna karena masih harus diperiksa oleh model utama.
Setelah mendapatkan draft token, target model memproses kandidat tersebut untuk menentukan apakah prediksinya dapat diterima. Beberapa token dapat diperiksa melalui satu proses sehingga tidak selalu diperlukan satu kali forward pass untuk setiap token. Menurut dokumentasi NVIDIA, speculative decoding menggunakan draft untuk memprediksi beberapa token di depan, kemudian target model melakukan verifikasi dalam satu forward pass.
Jika prediksi draft model sesuai dengan distribusi keluaran target model, token tersebut dapat diterima. Semakin banyak kandidat yang diterima, semakin besar potensi pengurangan waktu generasi. Karena itu, salah satu metrik penting dalam speculative decoding adalah acceptance rate. NVIDIA juga mencatat bahwa tingkat penerimaan sangat bergantung pada jenis workload, misalnya coding, matematika, atau penulisan.
Perbedaan utama kedua pendekatan terletak pada bagaimana token berikutnya dihasilkan. Pada standard decoding, model utama secara berurutan menghasilkan token. Sementara itu, speculative decoding LLM menambahkan tahap prediksi dan verifikasi.
| Aspek | Decoding Biasa | Speculative Decoding |
|---|---|---|
| Model utama | Satu target model | Draft + target model atau mekanisme sejenis |
| Prediksi | Satu token per iterasi | Beberapa kandidat token |
| Verifikasi | Tidak ada tahap khusus | Dilakukan oleh target model |
| Fokus optimasi | Kesederhanaan | Mengurangi latency |
| Kinerja | Bergantung pada target model | Bergantung pada acceptance rate dan hardware |
| Infrastruktur | Relatif sederhana | Membutuhkan konfigurasi tambahan |
Pendekatan ini tidak otomatis membuat seluruh aplikasi LLM menjadi lebih cepat. Efektivitasnya dipengaruhi karakteristik model, workload, hardware, jumlah token yang diprediksi, serta seberapa sering prediksi dapat diterima.
Setelah memahami mekanismenya, pertanyaan berikutnya adalah mengapa teknik ini digunakan dalam sistem LLM. Manfaat utamanya berkaitan dengan efisiensi proses inference dan pengalaman pengguna.
Speculative decoding LLM dapat membantu mengurangi per-token latency karena beberapa kandidat dapat diverifikasi dalam satu proses. Teknik ini terutama menarik untuk aplikasi yang membutuhkan respons cepat.
Contohnya adalah AI assistant, chatbot, coding assistant, dan aplikasi interaktif lain yang menampilkan respons secara streaming.
GPU tidak selalu digunakan secara optimal pada setiap pola LLM inference. Pada batch size kecil, proses generasi satu token secara berurutan dapat membuat pemanfaatan komputasi kurang efisien. NVIDIA menjelaskan bahwa speculative decoding dapat membantu mengurangi rata-rata per-token latency dalam kondisi tertentu.
Keunggulan lainnya adalah model utama tetap menjadi pihak yang melakukan verifikasi. Dengan pendekatan speculative sampling tertentu, tujuan teknik ini adalah mempercepat proses tanpa mengubah distribusi keluaran target model.
Namun, implementasi aktual tetap harus diuji karena performa dan perilaku dapat berbeda berdasarkan model, metode speculation, serta konfigurasi inference engine.
Speculative decoding LLM tidak hanya mempunyai satu metode. Perkembangan teknik ini menghasilkan beberapa pendekatan yang dapat dipilih berdasarkan arsitektur model dan kebutuhan sistem.
Pendekatan ini menggunakan LLM berukuran lebih kecil sebagai draft model. Model tersebut membuat beberapa prediksi, kemudian model besar melakukan verifikasi.
Metode ini relatif mudah dipahami karena memisahkan fungsi prediksi dan verifikasi. Namun, draft model perlu mempunyai kompatibilitas tertentu dengan target model, termasuk tokenizer yang sesuai pada implementasi tertentu.
EAGLE menggunakan pendekatan draft head untuk memprediksi informasi yang dapat digunakan dalam proses generasi. NVIDIA mendokumentasikan EAGLE-3 sebagai salah satu pendekatan speculative decoding yang dapat digunakan bersama TensorRT-LLM.
Pada contoh NVIDIA, EAGLE-3 dapat memberikan peningkatan performa dibandingkan vanilla decoding pada konfigurasi tertentu. Namun, angka performa tidak dapat dianggap sebagai hasil universal karena bergantung pada hardware, model, dan dataset yang digunakan.
Selain EAGLE, terdapat pendekatan seperti Medusa, Lookahead, dan metode lainnya. TensorRT-LLM mendokumentasikan beberapa metode decoding tersebut dalam ekosistem optimasi LLM.
Pemilihan metode sebaiknya dilakukan berdasarkan kompatibilitas model, inference engine, hardware, serta hasil benchmark.
Tidak semua sistem akan mendapatkan peningkatan performa yang sama. Karena itu, beberapa parameter perlu diperhatikan sebelum menerapkan speculative decoding LLM.
Acceptance rate menunjukkan seberapa banyak draft token yang dapat diterima oleh target model. Semakin tinggi tingkat penerimaan dalam kondisi yang sama, semakin besar peluang teknik ini memberikan manfaat.
Karakter workload sangat berpengaruh. Prediksi untuk coding dapat mempunyai karakter berbeda dibandingkan pembuatan ringkasan, sehingga hasil benchmark perlu menggunakan skenario yang mendekati penggunaan sebenarnya.
Draft model yang terlalu besar dapat mengurangi keuntungan karena membutuhkan komputasi tambahan. Sebaliknya, model yang terlalu kecil mungkin menghasilkan prediksi yang kurang sering diterima.
Karena itu, perusahaan perlu mencari konfigurasi yang seimbang antara kecepatan prediksi dan tingkat penerimaan.
Jumlah token yang diprediksi dalam satu tahap juga memengaruhi performa. NVIDIA menyediakan parameter seperti num draft tokens dalam implementasi speculative decoding tertentu.
Nilai yang terlalu rendah mungkin membatasi potensi percepatan, sedangkan nilai yang terlalu tinggi dapat meningkatkan pekerjaan yang akhirnya tidak diterima.
Penerapan speculative decoding LLM tetap membutuhkan infrastruktur yang mampu menjalankan target model dan komponen pendukungnya secara efisien. Karena itu, pemilihan GPU server perlu dilakukan berdasarkan ukuran model dan pola inference.
Untuk kebutuhan AI enterprise, GPU Server Indonesia dari Sparta Server Indonesia dapat digunakan sebagai bagian dari perencanaan infrastruktur. Pilihan GPU dapat disesuaikan dengan kebutuhan VRAM, jumlah model, dan skenario deployment.
Ekosistem NVIDIA relevan untuk speculative decoding karena beberapa inference engine mendukung optimasi LLM pada GPU NVIDIA. TensorRT-LLM sendiri dirancang untuk mengoptimalkan LLM inference pada NVIDIA GPU.
Untuk kebutuhan berbeda, perusahaan dapat mempertimbangkan:
Pemilihan GPU sebaiknya tidak hanya berdasarkan nama GPU, tetapi mempertimbangkan VRAM, memory bandwidth, jumlah pengguna, concurrency, dan hasil benchmark.
Hardware yang kuat membutuhkan software stack yang sesuai agar kemampuan GPU dapat dimanfaatkan secara optimal. Salah satu ekosistem yang relevan adalah TensorRT-LLM. TensorRT-LLM menyediakan optimasi untuk LLM inference, termasuk quantization, in-flight batching, paged KV caching, serta beberapa metode decoding. Dokumentasi NVIDIA juga menyediakan support matrix untuk model dan GPU yang kompatibel.
Pada deployment tertentu, TensorRT-LLM dapat digunakan bersama Triton Inference Server. NVIDIA mendokumentasikan dukungan speculative decoding dengan beberapa pendekatan dan konfigurasi pada ekosistem tersebut.
Teknik ini paling masuk akal ketika aplikasi mempunyai kebutuhan latency yang cukup ketat dan pola inference yang memungkinkan banyak draft token diterima. Contohnya adalah chatbot internal, AI assistant, coding assistant, dan layanan generasi teks interaktif.
Sebaliknya, jika workload sangat berbeda atau acceptance rate rendah, tambahan proses prediksi dapat memberikan manfaat yang lebih kecil. Karena itu, perusahaan sebaiknya melakukan benchmark sebelum mengadopsinya sebagai konfigurasi produksi.
Untuk kebutuhan proof of concept, perusahaan juga dapat mempertimbangkan opsi Sewa Server, termasuk Sewa Server Dell PowerEdge, HP ProLiant/HPE, Huawei, atau Lenovo sesuai ketersediaan konfigurasi. Pendekatan ini dapat membantu pengujian workload sebelum melakukan pengadaan infrastruktur secara penuh.
Performa LLM tidak hanya ditentukan oleh GPU. Sistem produksi membutuhkan storage, networking, monitoring, serta dukungan operasional agar layanan dapat berjalan konsisten.
Untuk workload yang menggunakan beberapa node, Network & Routing perlu diperhatikan karena komunikasi antarkomponen dapat memengaruhi performa. Sementara itu, storage dibutuhkan untuk model, cache, container, dataset, dan log.
Perusahaan juga dapat memanfaatkan layanan Managed IT & Support, seperti instalasi dan konfigurasi server, setup Proxmox, VMware, Mikrotik & Cisco, troubleshooting sistem server, hingga maintenance. Dukungan tersebut relevan ketika deployment LLM melibatkan lebih banyak komponen daripada sekadar satu GPU server.
Untuk lingkungan produksi, Data, Monitoring & Availability juga penting. Monitoring dapat digunakan untuk mengawasi GPU, CPU, RAM, storage, latency, dan error rate sehingga masalah dapat ditemukan lebih cepat.
Sebelum digunakan dalam produksi, lakukan benchmark menggunakan model dan skenario yang sama dengan kebutuhan sebenarnya. Jangan hanya mengandalkan spesifikasi GPU atau angka performa dari konfigurasi berbeda.
Beberapa metrik yang dapat dibandingkan meliputi:
Pengujian sebaiknya membandingkan baseline tanpa speculative decoding dengan konfigurasi yang menggunakannya. Dengan begitu, perusahaan dapat mengetahui apakah optimasi benar-benar memberikan perubahan yang berarti pada workload mereka.
Bagian berikut merangkum pertanyaan umum yang sering muncul ketika perusahaan mulai mempertimbangkan teknik optimasi LLM inference ini.
Speculative decoding LLM adalah teknik yang menggunakan prediksi dari komponen yang lebih ringan untuk menghasilkan beberapa kandidat token, kemudian memvalidasinya dengan target model.
Tidak selalu. Performa bergantung pada acceptance rate, model, workload, hardware, dan konfigurasi inference engine.
Tidak selalu. Konfigurasi bergantung pada metode yang digunakan. Beberapa pendekatan dapat dijalankan pada satu GPU dengan komponen draft tertentu.
Bisa. Ekosistem seperti TensorRT-LLM dan Triton mendukung berbagai pendekatan speculative decoding pada konfigurasi yang kompatibel.
Bisa dipertimbangkan, terutama ketika chatbot membutuhkan respons cepat. Namun, kelayakannya tetap perlu divalidasi melalui benchmark sesuai model dan pola penggunaan.