Server AI untuk Universitas dan Riset: Cara
September 30, 2026
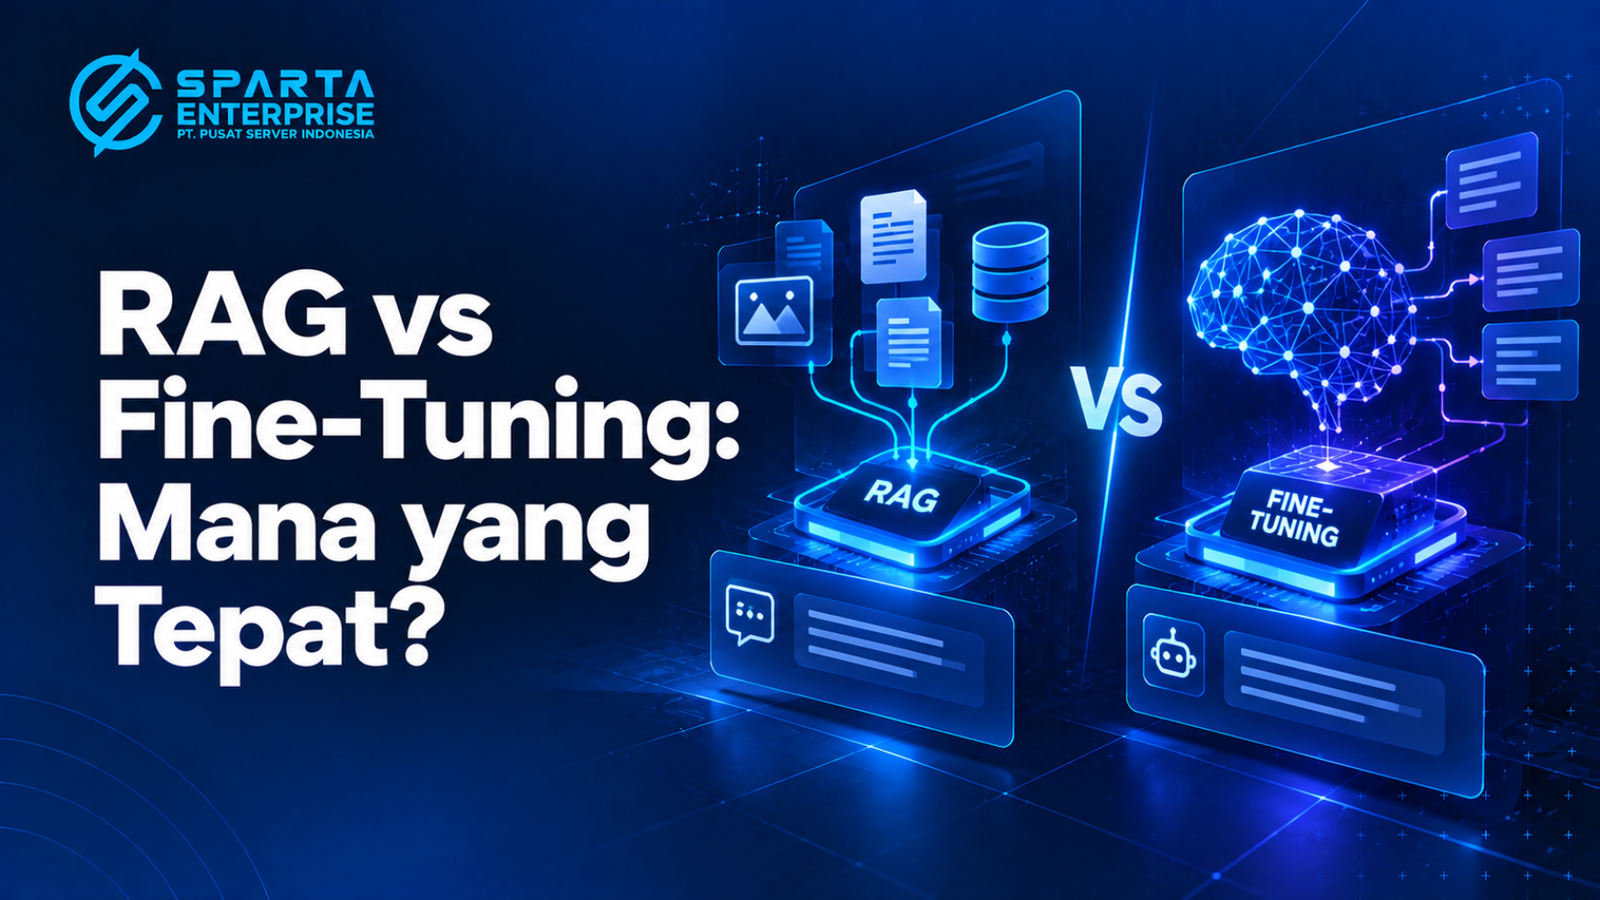
Ketika perusahaan mulai menerapkan LLM, satu pertanyaan sering muncul: apakah model cukup memperoleh akses ke data perusahaan, atau perlu menjalani pelatihan tambahan? Pertanyaan tersebut membuat RAG vs fine tuning menjadi topik penting dalam pengembangan Generative AI, terutama ketika perusahaan ingin membangun AI assistant, chatbot internal, atau aplikasi berbasis knowledge base.
RAG dan fine-tuning memang sama-sama membantu perusahaan menyesuaikan LLM, tetapi keduanya bekerja dengan mekanisme berbeda. RAG mengambil informasi relevan dari sumber eksternal saat pengguna mengajukan pertanyaan. Sebaliknya, fine-tuning melatih model menggunakan dataset tertentu agar model mengikuti pola, format, atau perilaku yang perusahaan inginkan. Perbedaan cara kerja tersebut ikut menentukan kebutuhan data, GPU, storage, biaya, dan arsitektur server.
Sebelum membahas RAG vs fine tuning lebih jauh, pahami terlebih dahulu fungsi dasar kedua pendekatan tersebut. RAG berfokus pada akses informasi, sedangkan fine-tuning berfokus pada penyesuaian kemampuan atau perilaku model.
RAG atau Retrieval-Augmented Generation menghubungkan LLM dengan sumber informasi eksternal. Sistem mengambil data yang relevan dari dokumen, database, atau knowledge base, kemudian memberikan informasi tersebut kepada LLM sebagai konteks.
Dalam arsitektur RAG, perusahaan biasanya memproses dokumen melalui chunking dan embedding. Sistem kemudian menyimpan hasilnya dalam vector database. Ketika pengguna mengajukan pertanyaan, mekanisme retrieval mencari informasi yang paling relevan sebelum LLM menyusun jawaban. Pendekatan ini sangat berguna ketika informasi perusahaan sering mengalami perubahan. Tim dapat memperbarui dokumen atau database tanpa harus melatih kembali seluruh model.
Fine-tuning memberikan pelatihan tambahan kepada model yang sudah memiliki kemampuan dasar. Perusahaan memasukkan dataset khusus agar model lebih konsisten menjalankan tugas tertentu. Misalnya, tim ingin LLM mengikuti format laporan tertentu, menggunakan gaya komunikasi tertentu, atau menjalankan tugas dengan pola yang lebih spesifik. Dalam kondisi tersebut, fine-tuning dapat membantu model mempelajari pola dari contoh yang tersedia.
Metode seperti LoRA atau pendekatan parameter-efficient fine-tuning juga dapat mengurangi kebutuhan resource dibandingkan full fine-tuning pada skenario tertentu. Meski begitu, perusahaan tetap perlu menyiapkan GPU, dataset, storage, serta proses evaluasi.
Setelah memahami konsep dasar, perbandingan RAG vs fine tuning menjadi lebih mudah. RAG mengubah konteks yang diterima model saat inference, sedangkan fine-tuning mengubah kemampuan atau perilaku model melalui proses training.
| Aspek | RAG | Fine Tuning |
|---|---|---|
| Fokus utama | Menambahkan informasi | Menyesuaikan perilaku model |
| Sumber data | Dokumen atau database | Dataset pelatihan |
| Update informasi | Relatif cepat | Memerlukan training tambahan |
| Kebutuhan GPU | Utama untuk inference | Untuk training dan inference |
| Vector database | Umumnya diperlukan | Bukan komponen utama |
| Cocok untuk | Data dinamis dan knowledge base | Format, gaya, dan tugas tertentu |
| Dataset training | Tidak wajib | Wajib tersedia |
| Kombinasi | Bisa digabung dengan fine-tuning | Bisa digabung dengan RAG |
Perbedaan tersebut menunjukkan bahwa perusahaan tidak perlu melihat RAG dan fine-tuning sebagai dua teknologi yang saling menggantikan. Keduanya dapat menyelesaikan kebutuhan berbeda dalam satu ekosistem AI.
Pembahasan RAG vs fine tuning perlu melihat jenis masalah yang ingin perusahaan selesaikan. RAG biasanya cocok ketika LLM harus mengakses informasi yang berada di luar pengetahuan dasarnya.
Bayangkan perusahaan memiliki ribuan SOP yang terus mengalami pembaruan. RAG memungkinkan sistem mengambil versi dokumen terbaru tanpa mengubah parameter LLM. Tim cukup memperbarui sumber data, menjalankan proses embedding jika diperlukan, lalu memperbarui indeks pada vector database. Alur tersebut membuat pengelolaan informasi dinamis lebih praktis.
RAG juga cocok untuk AI assistant yang menjawab pertanyaan berdasarkan dokumen perusahaan. Sistem dapat mencari bagian dokumen yang relevan sebelum LLM memberikan respons. Contohnya mencakup pencarian SOP, dokumentasi produk, panduan teknis, informasi HR, hingga knowledge base customer service.
LLM tidak selalu mengetahui informasi terbaru dari sistem internal. RAG menjembatani kebutuhan tersebut dengan mengambil data langsung dari sumber yang perusahaan kelola.Arsitektur ini sangat relevan untuk aplikasi yang bergantung pada informasi operasional dan mengalami perubahan secara berkala.
Dalam perbandingan RAG vs fine tuning, fine-tuning lebih sesuai ketika perusahaan ingin mengubah cara model melakukan tugas tertentu. Fokusnya bukan sekadar memberi informasi tambahan.
Perusahaan dapat menggunakan fine-tuning ketika aplikasi membutuhkan pola output yang sangat konsisten. Contohnya berupa format laporan, struktur respons, atau pola klasifikasi tertentu. Model mempelajari contoh yang tersedia dalam dataset, sehingga perusahaan dapat mengarahkan pola output melalui proses training.
Kebutuhan komunikasi yang spesifik juga dapat menjadi alasan untuk mempertimbangkan fine-tuning. Misalnya, perusahaan ingin chatbot mengikuti gaya bahasa tertentu dalam melayani pelanggan. Model kemudian mempelajari pola dari contoh respons yang telah perusahaan siapkan.
Fine-tuning membutuhkan dataset yang relevan dan konsisten. Tim AI perlu menyiapkan contoh yang mencerminkan kondisi penggunaan sebenarnya agar model mempelajari pola yang sesuai. Semakin spesifik tugasnya, semakin penting kualitas dan representasi dataset tersebut.
Lingkungan enterprise membutuhkan pertimbangan yang lebih luas daripada sekadar kualitas jawaban. Saat membandingkan RAG vs fine tuning, perusahaan juga perlu melihat keamanan data, jumlah pengguna, latency, throughput, storage, dan kapasitas GPU. RAG biasanya melibatkan vector database, embedding, document processing, storage, dan LLM inference. Sementara itu, fine-tuning menambah kebutuhan GPU untuk training, storage untuk dataset dan checkpoint, serta resource untuk eksperimen.
Sparta Server Indonesia menyediakan Server AI Indonesia dan GPU Server Indonesia untuk berbagai AI workload. Konfigurasi server dapat menyesuaikan kebutuhan LLM, inference, training, machine learning, dan deep learning. Untuk kebutuhan komputasi GPU, perusahaan juga dapat mempertimbangkan NVIDIA GPU Server Indonesia. Sparta menyediakan pilihan NVIDIA H100, H200, B200, L40S, hingga RTX PRO sesuai kebutuhan workload.
Setelah menentukan pendekatan AI, perusahaan perlu menerjemahkan kebutuhan software menjadi spesifikasi hardware. RAG dan fine-tuning dapat berjalan pada infrastruktur yang sama dalam kondisi tertentu, tetapi beban komputasinya berbeda.
Server RAG perlu menangani LLM inference, retrieval, embedding, document processing, dan layanan aplikasi. Jika perusahaan menjalankan LLM secara lokal, VRAM GPU menjadi salah satu faktor utama. CPU dan RAM juga memiliki peran penting. CPU dapat menangani proses aplikasi dan pemrosesan dokumen, sedangkan RAM mendukung database, cache, dan layanan pendukung. Storage perlu menampung model, dokumen, indeks, embedding, serta data operasional. Ketika perusahaan memisahkan application server, database, dan GPU server, kebutuhan networking juga perlu masuk dalam perencanaan.
Fine-tuning memiliki kebutuhan GPU yang lebih besar karena server harus menjalankan proses training. Ukuran model, jumlah data, precision, metode fine-tuning, serta target waktu training akan memengaruhi kebutuhan resource. Untuk model berukuran besar, perusahaan dapat mempertimbangkan konfigurasi multi-GPU jika framework dan model mendukungnya. Storage juga perlu menyediakan ruang untuk dataset, model, checkpoint, dan hasil eksperimen.
Sparta menyediakan Server Machine Learning & Deep Learning untuk kebutuhan training dan inference. Perusahaan yang membutuhkan proses pengadaan juga dapat mempertimbangkan Pengadaan Server AI Indonesia sesuai kebutuhan capacity planning.
Perbandingan RAG vs fine tuning tidak selalu berakhir pada pilihan salah satu. Dalam kebutuhan tertentu, perusahaan dapat menggabungkan keduanya untuk menangani dua masalah yang berbeda. Fine-tuning dapat mengatur perilaku dan format output model. Setelah itu, RAG menyediakan informasi terbaru dari dokumen perusahaan ketika pengguna mengajukan pertanyaan.
Sebagai contoh, perusahaan dapat melatih model agar menghasilkan laporan dengan struktur tertentu. RAG kemudian mengambil data terbaru dari SOP, database, atau dokumen operasional untuk mengisi konteks jawaban. Kombinasi tersebut dapat memberikan fleksibilitas lebih besar, tetapi arsitekturnya juga menjadi lebih kompleks. Karena itu, perusahaan sebaiknya menguji kemampuan LLM dasar terlebih dahulu sebelum menambahkan proses fine-tuning.
Biaya RAG vs fine tuning bergantung pada workload dan arsitektur yang perusahaan pilih. Perusahaan perlu menghitung seluruh komponen, bukan hanya harga GPU. RAG dapat membutuhkan vector database, storage, embedding pipeline, dan retrieval system. Di sisi lain, fine-tuning membutuhkan GPU untuk training, storage untuk dataset dan checkpoint, serta resource tambahan selama proses eksperimen.
Jika data perusahaan sering berubah, RAG dapat mengurangi kebutuhan training ulang. Sebaliknya, perusahaan yang membutuhkan perilaku model lebih konsisten dapat mempertimbangkan fine-tuning ketika sudah memiliki dataset berkualitas. Benchmark dengan kondisi yang mendekati penggunaan nyata dapat membantu perusahaan menghitung kebutuhan tersebut secara lebih akurat.
Pemilihan teknologi AI membutuhkan analisis terhadap kebutuhan bisnis dan workload. Beberapa kesalahan berikut dapat membuat proyek membutuhkan resource lebih besar tanpa memberikan manfaat yang sebanding. Pertama, jangan langsung melakukan fine-tuning hanya karena LLM belum mengetahui dokumen internal. Jika perusahaan hanya ingin menambahkan informasi yang sering berubah, RAG dapat menjadi pendekatan yang lebih sederhana.
Kedua, jangan menganggap RAG selalu menghasilkan jawaban akurat. Kualitas chunking, embedding, retrieval, metadata, dan sumber data ikut menentukan kualitas konteks yang masuk ke LLM. Ketiga, jangan memilih GPU hanya berdasarkan jumlah parameter model. Context length, concurrency, precision, jumlah pengguna, dan target latency juga memengaruhi kebutuhan server.
Keempat, jangan mengabaikan keamanan. RAG yang terhubung dengan dokumen internal perlu menerapkan autentikasi, otorisasi, dan permission filtering agar pengguna hanya memperoleh informasi yang memang boleh mereka akses.
RAG maupun fine-tuning membutuhkan ekosistem infrastruktur yang saling terhubung. GPU hanya menjadi salah satu bagian dari keseluruhan sistem. Sparta menyediakan Core Server & Infrastruktur untuk kebutuhan server, storage, dan infrastruktur enterprise. Perusahaan juga dapat mengembangkan kebutuhan melalui kategori Server & Data Center sesuai skala implementasi.
Kebutuhan jaringan dapat diarahkan ke layanan Network & Routing, sedangkan perusahaan yang memerlukan pengelolaan sistem dapat mempertimbangkan Managed IT & Support. Layanan seperti Perawatan & Maintenance Berkala dan Troubleshooting Sistem Server juga dapat membantu menjaga infrastruktur tetap berjalan. Untuk proyek yang membutuhkan perangkat dalam periode tertentu, Sparta juga menyediakan Rental Perangkat IT. Sementara itu, Maintenance Plan dan Jasa IT Lifecycle dapat mendukung kebutuhan setelah sistem masuk tahap operasional.
Pada akhirnya, RAG vs fine tuning perlu perusahaan tentukan berdasarkan masalah yang ingin diselesaikan. RAG berfokus pada akses terhadap informasi eksternal, sedangkan fine-tuning berfokus pada penyesuaian kemampuan atau perilaku model. Jika perusahaan ingin membuat LLM menjawab berdasarkan dokumen yang sering berubah, RAG dapat menjadi pilihan yang relevan. Sebaliknya, kebutuhan terhadap format, gaya, atau perilaku tertentu dapat mengarah pada penggunaan fine-tuning.
Sebelum membeli GPU server atau memulai training, perusahaan sebaiknya menjalankan proof of concept. Gunakan data dan skenario yang mendekati kondisi produksi, lalu ukur kualitas output, retrieval accuracy, latency, throughput, penggunaan VRAM, CPU, RAM, dan storage. Hasil pengujian tersebut dapat menjadi dasar untuk menentukan konfigurasi server. Pendekatan ini juga membantu perusahaan menghindari pembelian hardware yang terlalu kecil maupun terlalu besar.
Sparta Server Indonesia menyediakan Server AI untuk LLM & Generative AI untuk perusahaan yang ingin menjalankan LLM dan Generative AI secara lokal. Untuk kebutuhan implementasi, Jasa Instalasi Server AI dapat membantu persiapan hardware, konfigurasi software environment, deployment, hingga pengujian sesuai workload. WhatsApp kami +62 878‑2224‑1000
Bagian FAQ berikut merangkum pertanyaan umum seputar RAG vs fine tuning secara singkat.
RAG memberikan konteks dari sumber eksternal saat inference, sedangkan fine-tuning melakukan training tambahan pada model.
Tidak selalu. Pemilihannya bergantung pada tujuan, data, dan kebutuhan aplikasi AI.
Jika LLM berjalan secara lokal, GPU umumnya diperlukan untuk proses inference. RAG sendiri tidak selalu membutuhkan GPU lokal.
Ya. Fine-tuning umumnya membutuhkan GPU dengan kapasitas yang menyesuaikan model dan dataset.
Bisa. Fine-tuning dapat mengatur perilaku model, sedangkan RAG menyediakan informasi dari sumber eksternal.
RAG cocok ketika LLM perlu menjawab berdasarkan dokumen atau data perusahaan yang sering berubah.
Fine-tuning cocok ketika perusahaan ingin menyesuaikan format, gaya, perilaku, atau kemampuan model pada tugas tertentu.