Server AI untuk Universitas dan Riset: Cara
September 30, 2026
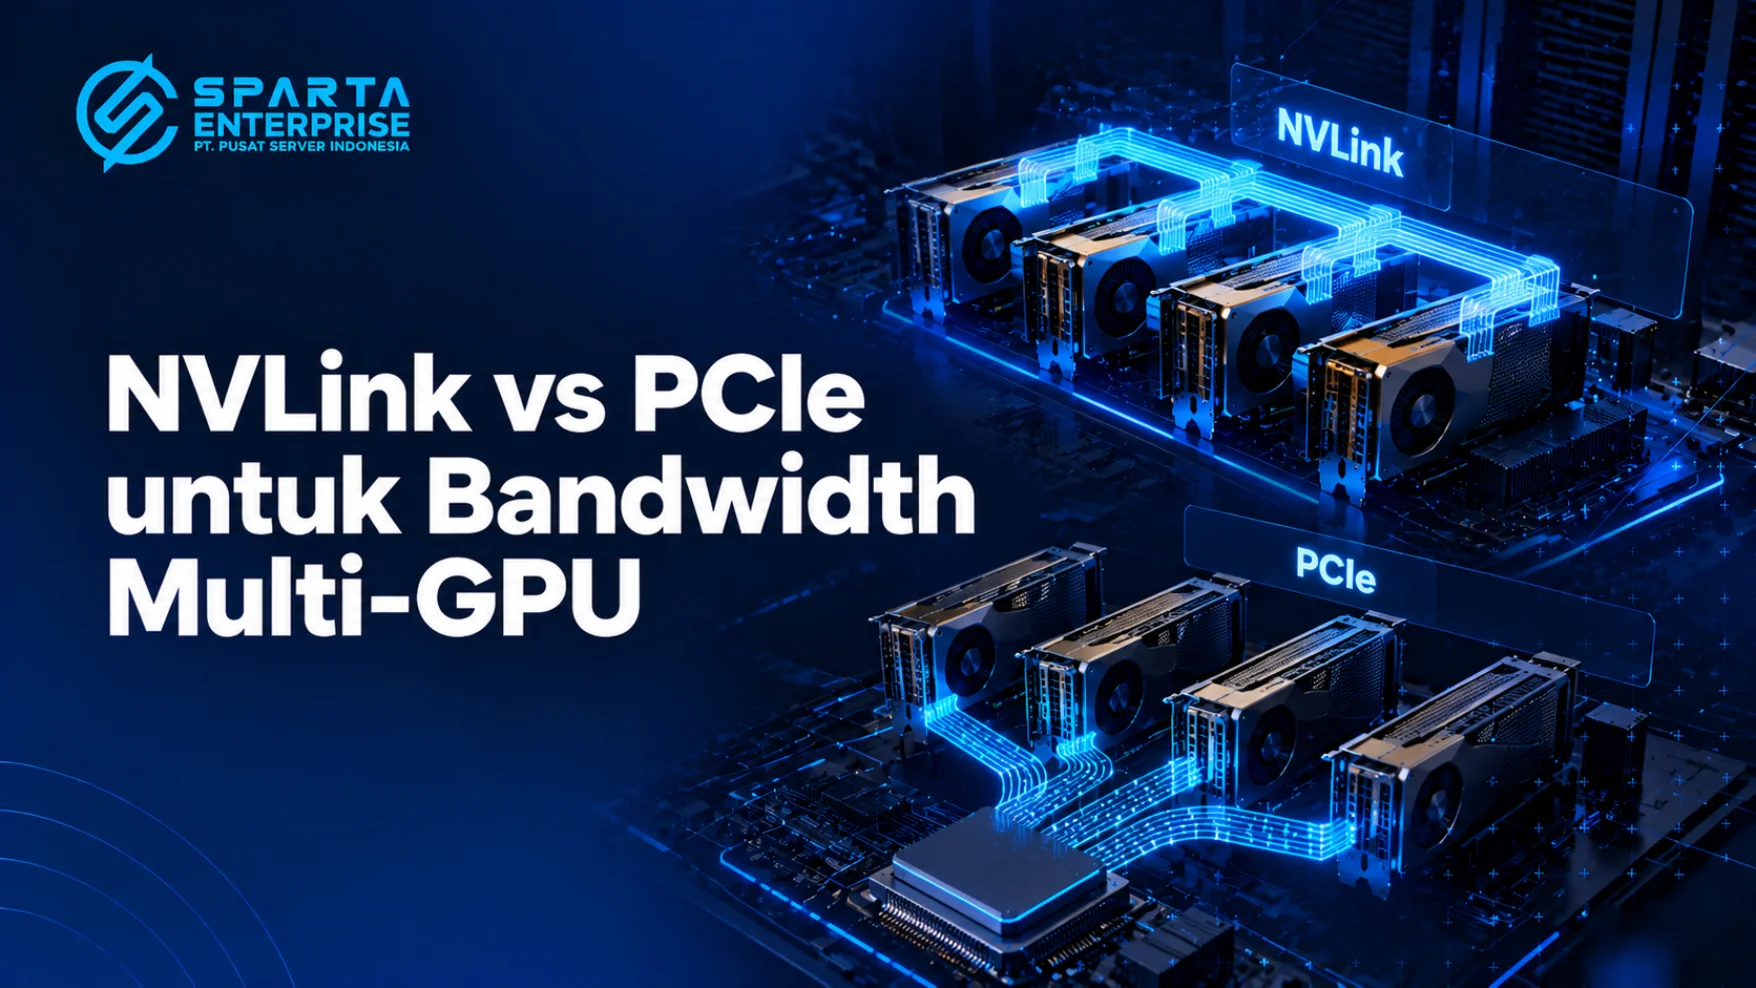
Menambah GPU ke dalam satu server memang bisa meningkatkan kapasitas komputasi. Namun, dua, empat, atau delapan GPU tidak selalu menghasilkan peningkatan performa yang sebanding jika setiap GPU harus menunggu data dari GPU lain. Pada kondisi seperti ini, jalur komunikasi antargPU ikut menentukan seberapa efisien server menjalankan workload.
Karena itu, pembahasan NVLink vs PCIe menjadi penting ketika perusahaan mulai membangun multi-GPU server untuk AI, LLM, deep learning, maupun HPC. Perbedaan bandwidth, topology, kompatibilitas, dan karakter workload dapat menentukan apakah server membutuhkan NVLink atau cukup mengandalkan PCIe.
Sebelum membandingkan NVLink vs PCIe, Anda perlu memahami fungsi kedua teknologi ini dalam sebuah server. Keduanya memang menghubungkan komponen komputasi, tetapi memiliki peran dan karakter yang berbeda.
NVLink merupakan teknologi interkoneksi NVIDIA yang fokus pada komunikasi berkecepatan tinggi antargPU dan komponen yang mendukung ekosistem NVLink. Teknologi ini membantu GPU bertukar data dengan bandwidth yang jauh lebih tinggi pada platform tertentu.
Sementara itu, PCIe atau Peripheral Component Interconnect Express merupakan standar interkoneksi umum pada server. GPU, NVMe, NIC, dan berbagai perangkat ekspansi lain dapat memanfaatkan jalur PCIe untuk berkomunikasi dengan sistem. Jadi, NVLink vs PCIe bukan sekadar perbandingan dua jenis konektor. Anda perlu melihat bagaimana aplikasi membagi pekerjaan dan seberapa sering GPU harus bertukar data.
Perbedaan paling penting terlihat pada fokus penggunaan dan kapasitas komunikasi. PCIe menawarkan fleksibilitas tinggi untuk berbagai perangkat, sedangkan NVLink berfokus pada komunikasi GPU berkecepatan tinggi.
| Aspek | NVLink | PCIe |
|---|---|---|
| Fokus | Komunikasi GPU-to-GPU | Interkoneksi perangkat secara umum |
| Target workload | AI, HPC, multi-GPU intensif | GPU server umum dan berbagai perangkat PCIe |
| Bandwidth | Sangat tinggi pada platform yang mendukung | Bergantung generasi dan jumlah lane |
| Kompatibilitas | Bergantung GPU dan platform | Sangat luas |
| Contoh | H100, H200, B200 pada platform tertentu | H100, H200, L40S, dan perangkat PCIe lainnya |
NVIDIA, misalnya, mencantumkan H200 SXM dengan NVLink hingga 900 GB/s, sedangkan PCIe Gen5 menyediakan bandwidth hingga 128 GB/s. H200 NVL juga menawarkan NVLink melalui konfigurasi bridge 2-way atau 4-way. Perbedaan tersebut menunjukkan mengapa bandwidth NVLink menjadi faktor penting ketika beberapa GPU harus berkomunikasi secara intensif.
Bandwidth antargPU menentukan seberapa cepat GPU dapat bertukar data. Semakin sering aplikasi melakukan komunikasi antar-GPU, semakin besar pengaruh bandwidth terhadap performa keseluruhan.
Bayangkan server memiliki empat GPU yang masing-masing mengerjakan bagian berbeda dari sebuah model. Jika GPU pertama harus mengirim hasil perhitungan ke GPU kedua sebelum proses berikutnya berjalan, waktu transfer ikut masuk ke dalam waktu eksekusi.
Dengan NVLink vs PCIe, perbedaan bandwidth dapat menjadi signifikan pada kondisi seperti ini. NVIDIA menyebut platform HGX H100/H200 mampu menyediakan GPU-to-GPU bandwidth hingga 900 GB/s melalui NVLink. Namun, bandwidth tinggi tidak otomatis mempercepat semua workload. Jika setiap GPU mengerjakan tugas secara independen, komunikasi antargPU mungkin relatif kecil sehingga PCIe sudah mencukupi.
Setelah mengetahui fungsi bandwidth, Anda perlu melihat bagaimana aplikasi AI memanfaatkan beberapa GPU. Tidak semua workload membagi data dengan cara yang sama. Pada model parallelism, misalnya, sistem membagi bagian model ke beberapa GPU. GPU kemudian perlu mengirim aktivasi atau data lain ke GPU berikutnya. Pola seperti ini membuat GPU-to-GPU communication menjadi bagian penting dari performa.
Distributed training juga membutuhkan komunikasi intensif ketika GPU melakukan sinkronisasi gradient dan parameter. Jika jalur komunikasi terlalu lambat, GPU bisa menghabiskan lebih banyak waktu untuk menunggu transfer data.
Karena itu, NVLink vs PCIe semakin relevan pada:
Sebaliknya, server yang menjalankan beberapa workload independen dapat memperoleh manfaat yang lebih kecil dari NVLink.
Training AI sering melakukan sinkronisasi data dalam jumlah besar. Ketika jumlah GPU bertambah, sistem perlu mengatur komunikasi agar setiap GPU tetap memperoleh data yang dibutuhkan tanpa menciptakan terlalu banyak waktu tunggu. Platform NVIDIA HGX H100 dan H200 menggunakan NVLink serta NVSwitch untuk menghubungkan delapan GPU dalam satu sistem. NVIDIA mencantumkan GPU-to-GPU bandwidth hingga 900 GB/s pada arsitektur tersebut.
Kondisi ini membuat NVLink sangat relevan untuk training model besar yang membagi workload ke banyak GPU. Namun, Anda tetap perlu memperhatikan algoritma komunikasi, batch size, parallelism strategy, CPU, RAM, dan software stack. Jadi, saat membandingkan NVLink vs PCIe, jangan hanya melihat angka bandwidth. Ukur juga pola komunikasi aplikasi agar pemilihan interconnect sesuai dengan kebutuhan nyata.
Inference LLM memiliki pola kerja yang berbeda dari training. Jika satu GPU mampu menampung seluruh model dan menangani request secara mandiri, kebutuhan komunikasi antargPU biasanya lebih rendah. Situasinya berubah ketika ukuran model melebihi kapasitas satu GPU. Sistem kemudian dapat membagi model ke beberapa GPU sehingga komunikasi antarperangkat menjadi lebih intensif.
Dalam kondisi tersebut, NVLink vs PCIe menjadi pertimbangan penting. Bandwidth antargPU yang lebih tinggi dapat membantu sistem memindahkan data antarGPU dengan lebih cepat, terutama ketika arsitektur inference memerlukan komunikasi berulang. NVIDIA H200, misalnya, menyediakan GPU memory sebesar 141 GB dan memory bandwidth 4,8 TB/s. Varian H200 SXM menawarkan NVLink 900 GB/s, sementara H200 NVL menggunakan konfigurasi NVLink bridge hingga 900 GB/s per GPU.
Tidak semua GPU NVIDIA mendukung NVLink. Karena itu, perusahaan perlu memeriksa spesifikasi GPU sekaligus platform server sebelum menyusun konfigurasi multi-GPU. NVIDIA L40S menjadi salah satu contoh. GPU ini menggunakan PCIe Gen4 x16 dengan bandwidth interconnect 64 GB/s bidirectional dan tidak memiliki dukungan NVIDIA NVLink.
Artinya, perusahaan tetap dapat membangun server dengan beberapa L40S, tetapi tidak bisa mengandalkan NVLink sebagai jalur komunikasi antargPU. Sebaliknya, lini seperti H100 dan H200 menawarkan platform yang mendukung NVLink. Karena itu, perusahaan perlu memilih GPU berdasarkan kombinasi VRAM, performa komputasi, interconnect, form factor, dan target workload.
Perbedaan spesifikasi setiap GPU membuat pemilihan interconnect perlu mengikuti kebutuhan workload. Berikut gambaran beberapa GPU NVIDIA yang relevan untuk server AI.
| GPU | Interconnect | Dukungan NVLink | Contoh workload |
|---|---|---|---|
| NVIDIA H100 | PCIe Gen5 / NVLink sesuai platform | Ya, pada platform tertentu | AI training, HPC, LLM |
| NVIDIA H200 | PCIe Gen5 / NVLink sesuai varian | Ya | LLM, training, inference |
| NVIDIA B200 | PCIe Gen5 + NVLink pada platform HGX | Ya | AI skala besar |
| NVIDIA L40S | PCIe Gen4 x16 | Tidak | AI inference, graphics, enterprise workload |
Pada HGX B200, NVIDIA mencantumkan generasi kelima NVLink dan NVSwitch dengan total aggregate bandwidth 14,4 TB/s. Sistem DGX B200 sendiri menggunakan delapan GPU B200 dan dua NVSwitch generasi kelima. Data tersebut menunjukkan bahwa platform AI kelas tinggi memang menggabungkan GPU, interconnect, dan topology khusus untuk menangani workload berskala besar.
Jawaban untuk pertanyaan NVLink vs PCIe tidak selalu sama untuk setiap server. PCIe tetap memiliki keunggulan dalam fleksibilitas dan kompatibilitas. Jika perusahaan hanya menjalankan satu GPU, misalnya, bandwidth GPU-to-GPU tidak menjadi faktor utama karena sistem tidak perlu mengirim data ke GPU lain. PCIe sudah memenuhi kebutuhan koneksi GPU dengan platform server.
PCIe juga bisa menjadi pilihan praktis ketika beberapa GPU menjalankan workload secara independen. Misalnya, satu GPU menangani inference model A, sedangkan GPU lain menangani model B. Dalam pola seperti ini, setiap GPU tidak harus terus-menerus bertukar data. Sebaliknya, NVLink GPU lebih relevan ketika beberapa GPU bekerja sebagai satu kesatuan komputasi dan melakukan pertukaran data secara intensif.
Bandwidth interconnect bukan satu-satunya faktor yang menentukan performa multi-GPU server. Anda juga perlu memperhatikan topology dan keseimbangan komponen lain. CPU, RAM, storage, PCIe lane, NIC, power supply, dan cooling harus mampu mengikuti kebutuhan GPU. NVIDIA sendiri merekomendasikan balanced PCIe topology dengan distribusi GPU secara merata pada CPU socket dan PCIe root port.
Pada server AI multi-node, networking juga memainkan peran penting. NVIDIA merekomendasikan koneksi jaringan berkecepatan tinggi untuk konfigurasi tertentu, terutama ketika sistem memperluas workload ke beberapa node. Karena itu, jangan memilih NVLink vs PCIe secara terpisah dari desain server. Interconnect harus mengikuti arsitektur GPU, CPU, memory, storage, dan networking secara keseluruhan.
Pemilihan NVLink vs PCIe sebaiknya dimulai dari karakter workload, bukan dari angka bandwidth terbesar. Anda perlu mengetahui bagaimana aplikasi membagi pekerjaan, berapa banyak GPU yang akan bekerja bersama, dan seberapa sering sistem memindahkan data antargPU. Untuk LLM inference, periksa ukuran model, VRAM, context length, jumlah pengguna bersamaan, latency, dan throughput. Untuk training, tambahkan ukuran model, strategi parallelism, frekuensi sinkronisasi, dan kebutuhan komunikasi.
Jika perusahaan membutuhkan GPU Server Indonesia untuk LLM, machine learning, deep learning, atau HPC, konfigurasi seperti NVIDIA H100, H200, B200, dan L40S dapat masuk dalam pertimbangan sesuai workload. Sparta Server Indonesia juga menyediakan kategori NVIDIA GPU Server Indonesia dan Server AI untuk LLM & Generative AI. Perusahaan dapat menyesuaikan pilihan GPU dan konfigurasi server berdasarkan kebutuhan komputasi serta rencana pengembangan.
Bandwidth antargPU menjadi semakin penting ketika aplikasi sering memindahkan data dalam jumlah besar. Kondisi ini biasanya muncul pada model parallelism, distributed training, dan workload AI yang membagi satu model ke beberapa GPU.
Sebaliknya, perusahaan tidak selalu membutuhkan NVLink ketika setiap GPU menangani workload yang terpisah. PCIe bisa menjadi pilihan yang lebih praktis untuk skenario tersebut. Jadi, NVLink vs PCIe perlu Anda nilai berdasarkan communication pattern. Dua server dengan jumlah GPU yang sama belum tentu membutuhkan interconnect yang sama karena aplikasi dan pola workload mereka bisa berbeda.
Membandingkan NVLink vs PCIe tidak cukup hanya dengan melihat angka bandwidth. Anda perlu menghubungkan kebutuhan interconnect dengan ukuran model, jumlah GPU, strategi parallelism, latency, throughput, dan pola komunikasi aplikasi. Untuk kebutuhan GPU Server AI, Sparta Server Indonesia menyediakan solusi NVIDIA GPU Server serta Server AI untuk LLM & Generative AI. Anda juga dapat mempertimbangkan layanan Server & Data Center untuk mendukung perencanaan infrastruktur secara lebih menyeluruh.
Jika perusahaan membutuhkan dukungan implementasi, layanan Managed IT & Support mencakup setup Proxmox, VMware, Mikrotik, dan Cisco, instalasi serta konfigurasi server dan jaringan, troubleshooting, hingga maintenance. Sementara itu, layanan Infrastruktur & Networking dapat mendukung kebutuhan server, jaringan, ISP, hardware, dan security.
Untuk kebutuhan jangka panjang, kategori Rental, Maintenance & Lifecycle juga dapat membantu perusahaan menyesuaikan pengadaan perangkat, maintenance plan, dan layanan IT lifecycle dengan kebutuhan operasional.Dengan pendekatan tersebut, perusahaan bisa menentukan apakah PCIe sudah mencukupi atau server membutuhkan arsitektur NVLink. Hasil benchmark workload nyata tetap menjadi dasar penting sebelum perusahaan memilih konfigurasi akhir.
Berikut beberapa pertanyaan yang sering muncul ketika perusahaan merancang server multi-GPU.
Ya, pada GPU dan platform yang mendukungnya, NVLink menawarkan bandwidth GPU-to-GPU yang jauh lebih tinggi daripada PCIe Gen5.
Ya. PCIe cocok untuk multi-GPU, terutama ketika setiap GPU menjalankan workload secara relatif independen.
Tidak. NVIDIA L40S menggunakan PCIe Gen4 x16 dan tidak mendukung NVLink.
Ya. H100 dan H200 memiliki varian atau platform yang mendukung NVLink dengan bandwidth sesuai konfigurasinya.
Tidak. Kebutuhannya bergantung pada ukuran model, jumlah GPU, strategi parallelism, dan intensitas komunikasi antargPU.
GPU memory bandwidth menunjukkan kecepatan GPU mengakses memory, sedangkan NVLink bandwidth menunjukkan kapasitas komunikasi melalui interconnect antargPU.